AI MV人物一致性方案
- 28 Sep, 2026
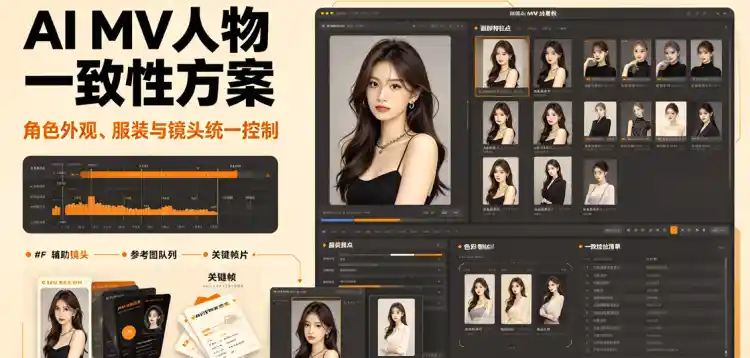
做AI MV最崩溃的事,不是生成慢,是一首歌下来人物换了8张脸。第一个镜头是圆脸,第二个镜头变方脸,第三个直接认不出来。副歌切回来,主唱跟主歌那个人完全不是同一个。
我帮朋友做过3支AI MV,每支都在人物一致性上踩过坑。从”完全没法看”到”基本能交活”,踩出了一套方法。这篇不讲”100%完美一致”(现在技术做不到),讲7个能把一致性从4分拉到8分的实操方法,每个方法都有适用场景和局限。
为什么AI MV的人物一致性特别难
普通AI视频只有几秒、一个场景、一个角度。一致性崩了也就崩了几秒。
MV不一样。3到5分钟、十几个场景、远近景切换、还要对口型。变量越多,崩的概率就指数级上升。
网上那些”一张参考图搞定一致性”的教程,放到单条短视频里可能够用,放到MV里根本不行。你会发现:第一个镜头还挺像的,换个场景就走样了,再换个角度直接变成另一个人。
所以MV场景的人物一致性,不是一个功能就能解决的事,是一套组合拳。
方法1:建立角色参考图集(基础中的基础)
这是所有方法的起点,没做好这一步后面全白搭。
一套合格的参考图集不是随便找几张图就行。要有结构:
- 正面清晰照:表情自然、光线均匀、五官完整。别选美颜过度的,AI识别不出来
- 侧面照:90度侧脸,能看到鼻子轮廓和下颌线
- 全身照:能看清服装、身材比例、整体风格
- 一张带情绪的表情参考:比如微笑或者专注的样子
- 再加一段精准的文字描述:发型、脸型、服装、显著特征(比如左边耳朵有个耳钉、左手有个纹身)
2到4张图就够,但每张都要高质量。模糊的、角度奇怪的、有遮挡的,不如不要。
最关键的纪律:每个镜头都用完全相同的参考图和完全相同的角色描述顺序。别这个镜头用2张图,那个镜头用3张图;别这段描述是”黑色长发”,那段又写成”长黑发”。差一个字,结果可能差很多。
第一次做MV的时候踩过这个坑。每个场景随手找一张参考图就生成了,结果人物差得离谱。后来统一用一套4张图加一段固定描述,一致性直接提升了一大截。说不上来提升了多少,但肉眼可见地稳了。
方法2:用角色锁定功能(各工具最佳实践)
现在主流AI视频工具基本都有角色锁定功能,但每个工具的用法和效果不一样。说一下我实际用过的三个主流工具的感受。
可灵(Kling)主体库
可灵的主体库3.0是目前中文工具里一致性最强的方案。
操作逻辑很简单:上传一张角色图,系统自动解析特征,还能一键生成不同角度和光线的变体。做视频的时候直接从主体库里调用角色就行。
优点:中文界面不用翻墙、一致性确实稳、支持最多3个主体同框。做写实风格和卡通风格都还行。
局限:大动作的时候偶尔会崩一下,比如跑跳或者大幅度转头。卡通风格比写实风格更稳一点。
即梦(Dreamina)Seedance
即梦的角色档案功能,适合追求电影感运镜的MV。
有两种方法保持一致。一种是人设提示词法——人物描述部分写死,只改动作和环境。另一种是参考图法——上传参考图,让AI跟着参考图的特征走。
即梦最大的优点是运镜好看,做出来的画面有电影感,适合追求MV质感的人。对口型效果也不错。
局限:快速运动的时候人脸容易糊。还有就是生成速度有时候比较慢,得等。
PixVerse Character 功能
PixVerse专门有个角色创建功能,操作最简单,新手友好。
上传一张图,起个名字,等它创建成功就能用了。适合做动漫、二次元风格的MV。
优点:操作简单,基本不会搞错。动漫风格的一致性出乎意料地好。
局限:写实风格的一致性不如前两个。功能相对少一些,高阶玩法不多。
方法3:固定关键词顺序与描述模板
很多人忽略这个细节,但影响其实不小。
AI生成视频的时候,prompt里前面的词权重更高,后面的权重更低。如果你每次人物描述的顺序不一样,AI”记住”的特征就不一样,生成出来的人自然就不一样。
正确做法是把人物描述做成一个固定模板,每次只改动作和环境部分,人物描述部分原封不动复制过去。
模板大概长这样:
[人物外观描述(完全不动)],正在[动作描述(每段改)],在[场景描述(每段改)],[风格描述(基本不动)]
人物描述内部的顺序也要固定。比如永远是:发型→脸型→服装→配饰→显著特征。别这次先说发型下次先说服装。
听起来很简单,但很多人就是图省事每次手敲,敲着敲着就改词了。我自己的做法是把人物描述存成一个txt文件,每次生成直接复制粘贴,只改后面的动作和环境。
方法4:分批次生成 + 质量筛选
不要指望一次生成就完美。AI是概率性的,同一个prompt生成四次,结果可能四次都不一样。
正确的姿势是同一个镜头生成4个版本,选最稳的那个。
筛选的时候看三个东西:
第一,面部特征跟参考图一致吗?这是底线。 第二,服装、发型、配饰有没有变?有时候脸没崩但衣服换了,一样出戏。 第三,动作过程中脸会不会崩?别只看第一帧,要看整个视频过程中有没有崩的帧。
副歌和特写镜头多生成几个版本,因为这些镜头观众看得最仔细。远景和侧脸可以少生成点,反正看不清。
做副歌的一个镜头时碰到过,生成了4版。第1版嘴歪了,第2版发型从直的变成卷的了,第3版动作太僵硬像机器人,第4版虽然也不是100%完美,但整体最稳。虽然花了3倍时间,但总比用一个崩的强。
别心疼那点生成额度。一个崩的镜头会把整支MV的质感拉下来。
方法5:对口型场景的一致性技巧(MV特有)
对口型是MV的特殊需求,也是一致性崩的重灾区。
为什么对口型容易崩?因为嘴部动起来之后,面部特征变化很大,AI很容易”认不出”这个人了。就像你戴口罩的时候人脸识别不好用一样的道理。
分享几个踩坑踩出来的实用技巧:
第一,对口型镜头用中近景,别用大特写。大特写把脸放大到整个屏幕,一点点不一致都看得清清楚楚。中近景有身体和环境做参照,反而不容易看出来。
第二,尽量选正脸或者微侧的角度,侧脸对口型更容易崩。侧脸的时候嘴部的变形大,AI很难同时保持脸型一致和口型准确。
第三,生成的时候在prompt里强调一下”保持面部特征不变”或者”consistent facial features”。有没有用不好说,但加了总比不加强。
第四,如果某个字的口型崩了,别整首重做。单独生成那个字或者那一句的片段,后期剪进去就行。
工具选择上,即梦和可灵的对口型效果相对较好,Pika类的工具对口型支持弱一些。
方法6:多人物MV的一致性方案(进阶)
乐队、组合、剧情类MV需要多个人物,难度直接翻倍。
核心原则:一个一个来,别同时生成多人物。同时生成两个人物,AI的注意力被分散,两个人物都容易崩。
我的做法是:
第一步,分别给每个人物建立独立的角色档案或者主体。每个人物单独测试,确保单个人物是稳的。 第二步,单人镜头分别生成。这部分是最稳的,占MV的主要篇幅。 第三步,多人同框的镜头单独处理。用参考图加主体库双保险,多生成几个版本选。 第四步,如果多人同框镜头实在崩得厉害,就拆——拆成两个单人镜头剪在一起,用正反打或者分屏的方式,观众完全感觉不出来。
帮朋友做一支双人乐队的MV时踩过这个坑。一开始非要追求两个人同框,结果每次总有一个人崩。后来改了思路,大部分镜头用单人,副歌的时候才用同框远景,不行就切正反打。剪完之后看,完全感觉不到是分开生成的,还显得镜头语言很丰富。
别被”同框”执念绑架了。真实的MV本来就是单人镜头+多人镜头交替的,单人多拍点,多人少拍点,一样好看。
方法7:崩了怎么救:后期修复技巧
不管多小心,总会有崩的镜头。别慌,能救。
按崩坏程度分三种处理方式:
轻度崩。比如某个表情不对、某个角度稍微有点走样。这种直接重新生成这个镜头,多试几个不同的seed或者改一两个词。一般生成三四次总能找到一个能用的。
中度崩。脸型变了,但五官位置差不多,整体轮廓还在。这种可以用AI换脸工具把正确的脸换回去。FaceSwapper或者一些AI视频换脸工具都能做。换完之后调个色,基本看不出来。
重度崩。整个脸都烂了、五官错位、或者动作过程中直接崩坏。这种别救了,救回来也不自然。要么剪掉用其他镜头替代,要么只保留远景或者背影,要么用特效糊过去。
后期修复的原则:能前期解决的别拖到后期。前期花10分钟多生成两个版本,比后期花半小时修脸强多了。后期只是兜底,不是主力。
不同预算的一致性方案选择
不用一上来就全套上,根据你的预算和需求选:
零预算版。就用免费额度,靠参考图集加固定prompt模板加多选优。效果大概4到5分,练练手没问题。
基础版。花一杯奶茶钱充个可灵或者即梦会员,用上角色锁定功能。效果大概6到7分,做出来的MV已经能看了。
专业版。角色锁定加分批生成加后期修复,三管齐下。效果能到8到9分,接近专业级MV的观感。
没有10分的方案。现在的技术还做不到逐帧完美一致。但真的不用追求10分,观众看MV看的是整体感觉,不是逐帧暂停下来验你的脸对不对。8分就够了。
常见问题(FAQ)
Q:AI MV人物能做到100%一致吗?
做不到。现在的技术水平,多场景MV能做到80%到90%一致就不错了。观众完全能接受。追求完美会累死,而且收益很低——从90分到95分花的时间,比从40分到80分还多。
Q:哪个AI工具做MV人物一致性最好?
综合来看可灵主体库最好,中文工具里最强,支持多主体。即梦的运镜和电影感更好但大动作容易糊。PixVerse适合动漫风格,写实风格一般般。
Q:一首歌做下来大概要生成多少个版本?
3分钟的歌,大概10到15个镜头,每个镜头生成4个版本选1个,总共40到60次生成。熟练了之后,有些简单的远景或者背影镜头可以少生成几个版本,总数能降下来。
Q:人物一致性能完全靠后期解决吗?
不能。前期做不好,后期再怎么修都不自然。前期一致性是主力,后期只是补漏。别想着”先生成再说,大不了后期修”,那样修出来的东西一眼假。
Q:写实风格和动漫风格哪个更容易保持一致?
动漫风格容易太多了。写实风格人脸细节多,差一点就看得出来;动漫风格容错率高很多,只要发型和颜色对得上,基本就觉得是同一个人。新手建议先从动漫风格练手。
Q:多人物MV是不是特别难做?
是,但有技巧。别追求每个镜头都同框,大部分单人镜头加少量多人远景,剪在一起观众感觉就是在一起。别给自己加难度。
总结
AI MV人物一致性,不是靠一个神奇功能,是一套组合拳。
参考图是基础,角色锁定是主力,prompt规范是细节,分批生成是保险,对口型技巧是MV特有,多人物方案是进阶,后期修复是兜底。从方法1开始,一个一个往上加,一致性会稳步提升。
不用追求100%完美。8分就够了。观众看MV看的是整体的情绪和感觉,不是拿着放大镜逐帧验你的脸对不对。